568 亿 token 之后:我怎么选模型和 Agent
从代码补全到桌面端 Agent,回顾 2025 年 11 月以来的模型与工具切换,以及我判断模型和 Agent 的标准。
本页目录14 节
本文写给刚开始用 AI 写代码的人。内容是我从 2025 年 11 月到 2026 年 9 月的个人使用记录,不是评测。模型和工具更新很快,文中结论只对应文中提到的版本和时间段。
先说结论:选模型要看任务需要什么,不看排行榜,也不看谁最贵。 下面是我这段时间换过的工具、换的理由,以及我现在判断模型和 Agent 好坏的几条标准。
一、先看数据:用得多,不等于出活最好
首页的 AI 用量面板记录了我自报的累计 token 数:
| 工具 | 累计 token | 占比 |
|---|---|---|
| Codex | 368 亿 | 约 65% |
| DeepSeek | 143 亿 | 约 25% |
| Claude | 57 亿 | 约 10% |
| 合计 | 568 亿 | 100% |
Claude 的用量最少,但在我的体验里,它交付的结果质量最好。
token 数量反映的是哪个工具在当时承担了主力工作、跑了多少长任务,而不是哪个模型更好。长程任务、反复读取项目文件、多轮自我验证,都会让 token 迅速累积。DeepSeek 的 143 亿也是这样来的:大部分不是我直接对话用掉的,而是后来让它作为执行者跑具体任务时累积的(见第二节"Codex 规划,DeepSeek 执行")。所以看自己的用量数据时,要把"用了多少"和"产出多好"分开看。
二、这段时间用过什么,为什么换
| 阶段 | 大致时间 | 主要工具 | 模型 | 我的角色 |
|---|---|---|---|---|
| 代码补全 | 2025 年 11 月起 | Antigravity | Gemini 3 Pro(默认模型) | 大部分代码自己写 |
| 接入 Claude | 2026 年 2 月起 | Claude Code CLI(经第三方中转) | Claude Opus 4.6 | 自己搭框架,AI 实现具体功能 |
| 尝试国产模型 | 2026 年 6 月起 | Claude Code CLI、CodeBuddy CLI | DeepSeek V4、MiMo V2.5、Qwen 3.7、GLM 4.7 | 同上 |
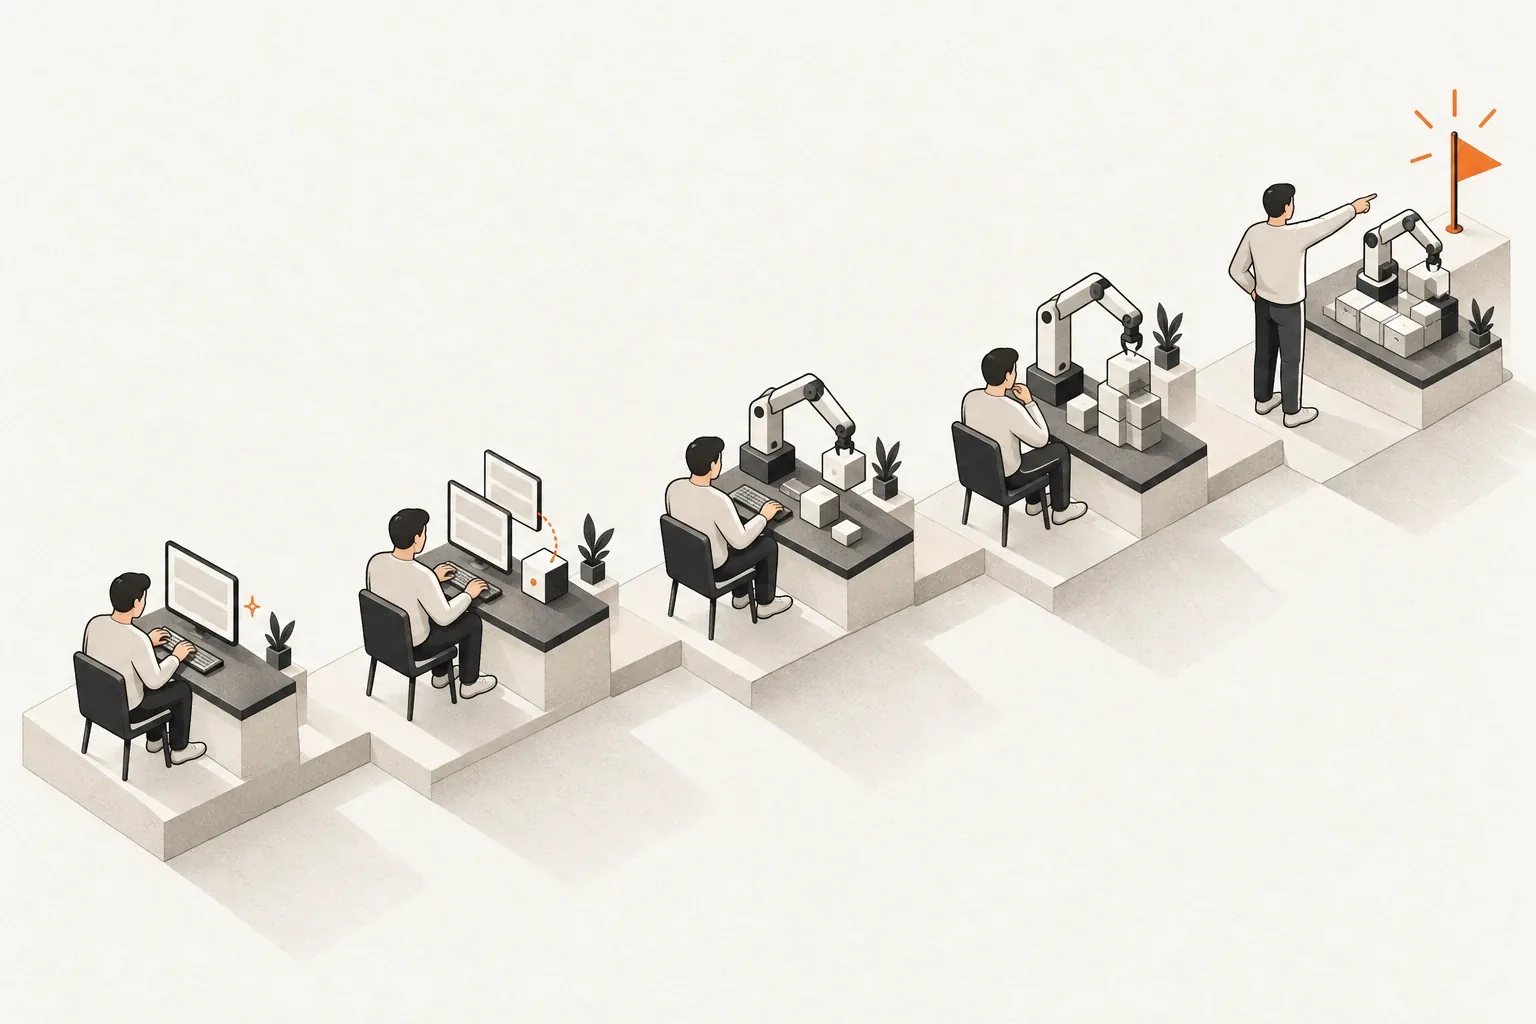
| 转向 Codex | 2026 年 7 月起 | Codex | GPT-5.4 / GPT-5.5 | 开发基本交给 AI |
| 全面使用 Codex 桌面端 | GPT-5.6 发布后 | Codex 桌面端(官方订阅) | GPT-5.6 | 开发基本交给 AI |
| Codex 规划,DeepSeek 执行 | DeepSeek V4 正式版和 DeepSeek Harness 发布后 | Codex 桌面端 + DeepSeek Harness | GPT-5.6 + DeepSeek V4 | 定目标,由 Codex 拆解和分派 |
| 回到 Claude | Opus 5.5 发布后 | Claude(Max 订阅) | Claude Opus 5.5 | 开发基本交给 AI |
从补全开始
最早用的是 Antigravity,用法和 VS Code 里的代码补全差不多:AI 帮我补几行,大部分代码还是自己一行一行写。
通过中转接入 Claude
后来我开始通过第三方中转使用 Claude,在 Claude Code CLI 里接 Opus 4.6。我遇到的站主做事规矩,这一点比较幸运。
那时的模型和 Agent 还撑不起一个大型项目从零起步。我的做法是自己先搭好项目框架,再让 AI 实现具体功能。
因为便宜,尝试国产模型
用量上来以后,我开始尝试更便宜的国产模型:DeepSeek V4、MiMo V2.5、Qwen 3.7 和 GLM 4.7。
做一些小功能和小任务,这些模型都够用。但也遇到过这样的情况:不管我把开发流程和实现方法描述得多细,它们还是写不出来。那时我意识到,国产模型的能力目前还有明显的上限,所以这个阶段 DeepSeek 我用得并不多。
转向 Codex:Harness 和模型一样重要
后来有朋友推荐 Codex。刚开始并不顺手,适应了好一段时间。
真正让我改变看法的是 /goal 命令,它帮我解决了项目从零到一快速起步的问题。我由此意识到:一家 AI 公司的 harness,也就是模型外面那一层负责规划、调用工具、管理上下文和执行任务的程序,和模型能力本身同样重要。同一个模型放在不同的 harness 里,完成长任务的能力可能差很多。
GPT-5.6 之后,全面转到 Codex 桌面端
GPT-5.6 发布后,我把开发全部转到了 Codex 桌面端,主要原因是整个过程都看得很清楚:模型的思考过程、内置浏览器预览、代码改动的 diff、任务进度,都在同一个界面里。
同一时期我停用了中转,开通了官方订阅(20x 套餐)。原因有两个:
- 算下来,中转相比官方订阅没有明显的价格优势。
- 中转不是官方渠道,很多能力用起来不如直接开账号流畅。
Codex 规划,DeepSeek 执行
DeepSeek V4 正式版和 DeepSeek Harness(DSH)发布以后,我换了一种用法:让 Codex 通过 browser use 在 DSH 里下指令,由 DeepSeek 去实现特定功能。
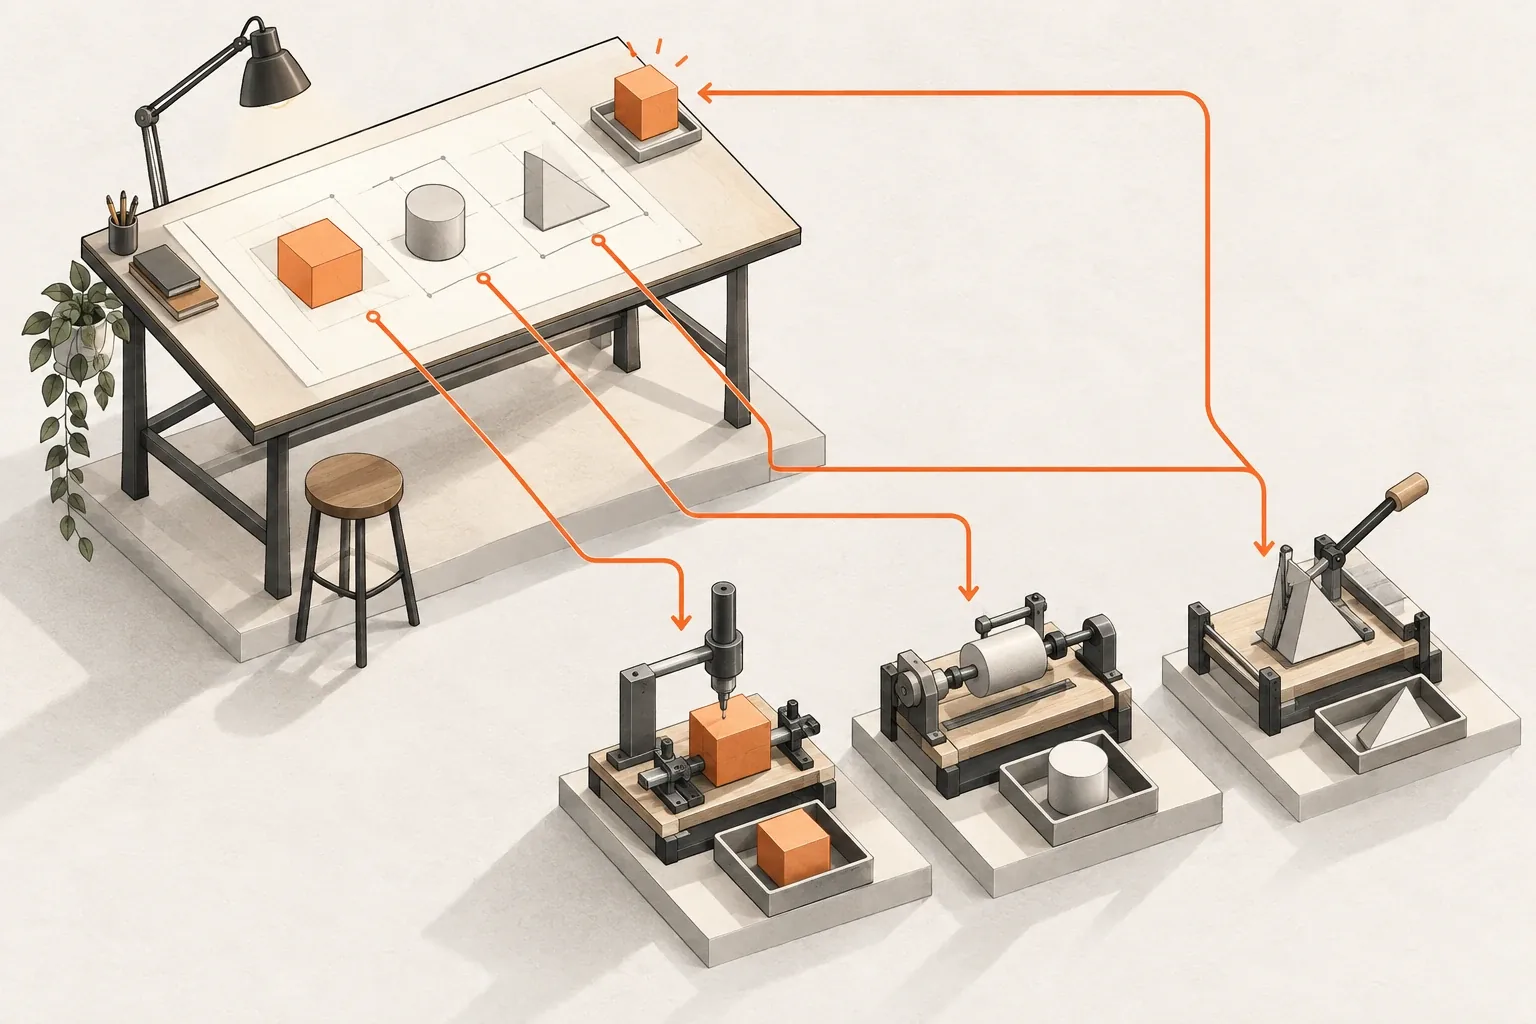
这样分工,Codex 是总控和规划者,负责拆解任务、写清指令、检查结果;DeepSeek 是执行者,负责具体实现。规划需要更强的理解和判断,执行则可以交给更便宜的模型。DeepSeek 的大部分 token 就是在这个阶段用掉的。
这也是"按任务选模型"最直接的例子:同一个项目里,不同环节可以交给不同的模型。
最近:回到 Claude
Opus 5.5 发布后,我开通了 Claude Max,把主力切回 Claude。
另一个原因是稳定性。近期使用 Codex 时,我感到输出质量波动明显,同类任务的表现时好时坏。我没法确认具体原因,但稳定性正是我最看重的一点。
现在我几乎全部转到了 Claude。Codex 更多用来做自动化类的工作,比如视频制作,以及一些小功能的改动。
三、我怎么判断一个模型好不好
我对模型的要求只有四条:
- 听得懂人话。 需求描述不必像规格文档那样严格,模型也能理解我真正想要什么。
- 按指令执行。 让它做什么就做什么,不擅自扩大改动范围,也不自作主张加功能。
- 指哪打哪,不漂移。 任务做到后半段,仍然记得最初的目标和约束。
- 至少有多模态能力。 能看截图、看界面。前端开发和排查问题时,很多信息只能靠图片传达。
这几条听起来朴素,但在长任务里,差别会被放大。排行榜上的分数很难反映"会不会漂移",只能靠自己在真实任务里观察。
四、我怎么判断一个 Agent 好不好
模型决定能力的上限,Agent(harness)决定这些能力能不能稳定地发挥出来。我看四点:
- 能让模型稳定执行长程任务,不漂移。 任务拆解、进度跟踪和上下文管理都做得好,模型才能连续工作很久而不跑偏。
- 至少要有 computer use。 能自己打开浏览器或应用、看界面、点按钮、检查结果。实际用下来,这对前端开发和端到端验证非常实用;前面 Codex 指挥 DeepSeek 的分工,也是靠 browser use 才跑得起来。
- 缓存命中率要高。 长任务会反复读取同样的上下文,缓存命中率直接影响成本和速度。
- UI 用着舒服。 每天要用很多小时,信息清楚、操作顺手,本身就能提高效率。
五、给刚开始用 AI 写代码的人
以下是我自己的经验,不一定适合每个人:
- 先想清楚任务需要什么,再选模型。 简单明确的任务可以用便宜的模型;需要理解意图、执行长流程的任务,值得用更稳定的模型。同一个项目里,也可以让强模型做规划、便宜的模型做执行。
- Agent 还不够可靠时,先自己搭框架。 由你定好项目结构,AI 负责实现具体功能,返工会少很多。等手上的 Agent 能稳定完成长任务,再把更多工作交给它。
- 把 Agent 当成和模型同等重要的选择。 同一个模型,换一个 harness,体验可能完全不同。
- 算清楚总成本。 便宜的渠道不一定真的便宜,还要算上稳定性、功能缺失和返工的时间。
- 定期重新评估。 模型和工具几个月就更新一代,今天的结论,下个季度可能就要改。
最后一条最重要:AI 只是工具,决定产出质量的,始终是使用它的人。
六、这份结论的有效期
本文记录的是 2025 年 11 月到 2026 年 9 月的使用经历,涉及的模型和套餐以文中写到的版本为准。等新模型发布,或者 Agent 出现新的能力,我会重新评估自己的选择。
继续阅读
AI 编程实践:上下文、验证与成本讲如何准备上下文和控制成本,AI 编程工作流:实现、审查与决策讲实现与独立审查的配合方式,CLAUDE.md 配置实践讲如何用配置文件约束模型的行为,给 AI 分派任务之后,如何把结果带回原会话介绍我为 DeepSeek Harness 开发的子任务插件。
全文完
继续阅读