Conuo:把原文、AI 问答和学习笔记放在一起
Conuo 的开发与使用流程:在原文旁提问、核对引用与图表,将理解整理为笔记,并审核 AI 生成的知识页草稿。
本页目录
读技术资料时,一个常见的问题是:AI 给出了很完整的解释,但要确认其中某句话,仍得回到原文,找页码、看公式,再判断解释有没有超出资料。讨论结束后,还要把有用的内容从聊天里整理出来。
我做的 Conuo 是一个正在开发的 AI 学习工作台。它把资料阅读、带引用的问答和笔记编辑放在同一个工作区,让用户可以边看原文边提问,再把核对后的内容留下来。
本文用自编的“导数与切线”联调资料说明这套流程。界面截图来自本地开发版本;功能与验证范围以 2026 年 9 月 15 日的开发记录为准,尚未公开部署。
它具体帮助在哪一步
Conuo 处理的是阅读过程中几项相互关联的操作。资料导入后,用户选择本次问题能使用的范围;回答中的引用提供返回原文的入口;有用的回答可以进一步整理为笔记,或作为知识页草稿供审核。
例如,读一份带公式与图像的材料时,可以把 PDF 留在左侧,在右侧问“为什么这里的割线斜率还不等于导数”。收到回答后,直接对照引用中的计算和图像,而不是只检查文字听起来是否合理。
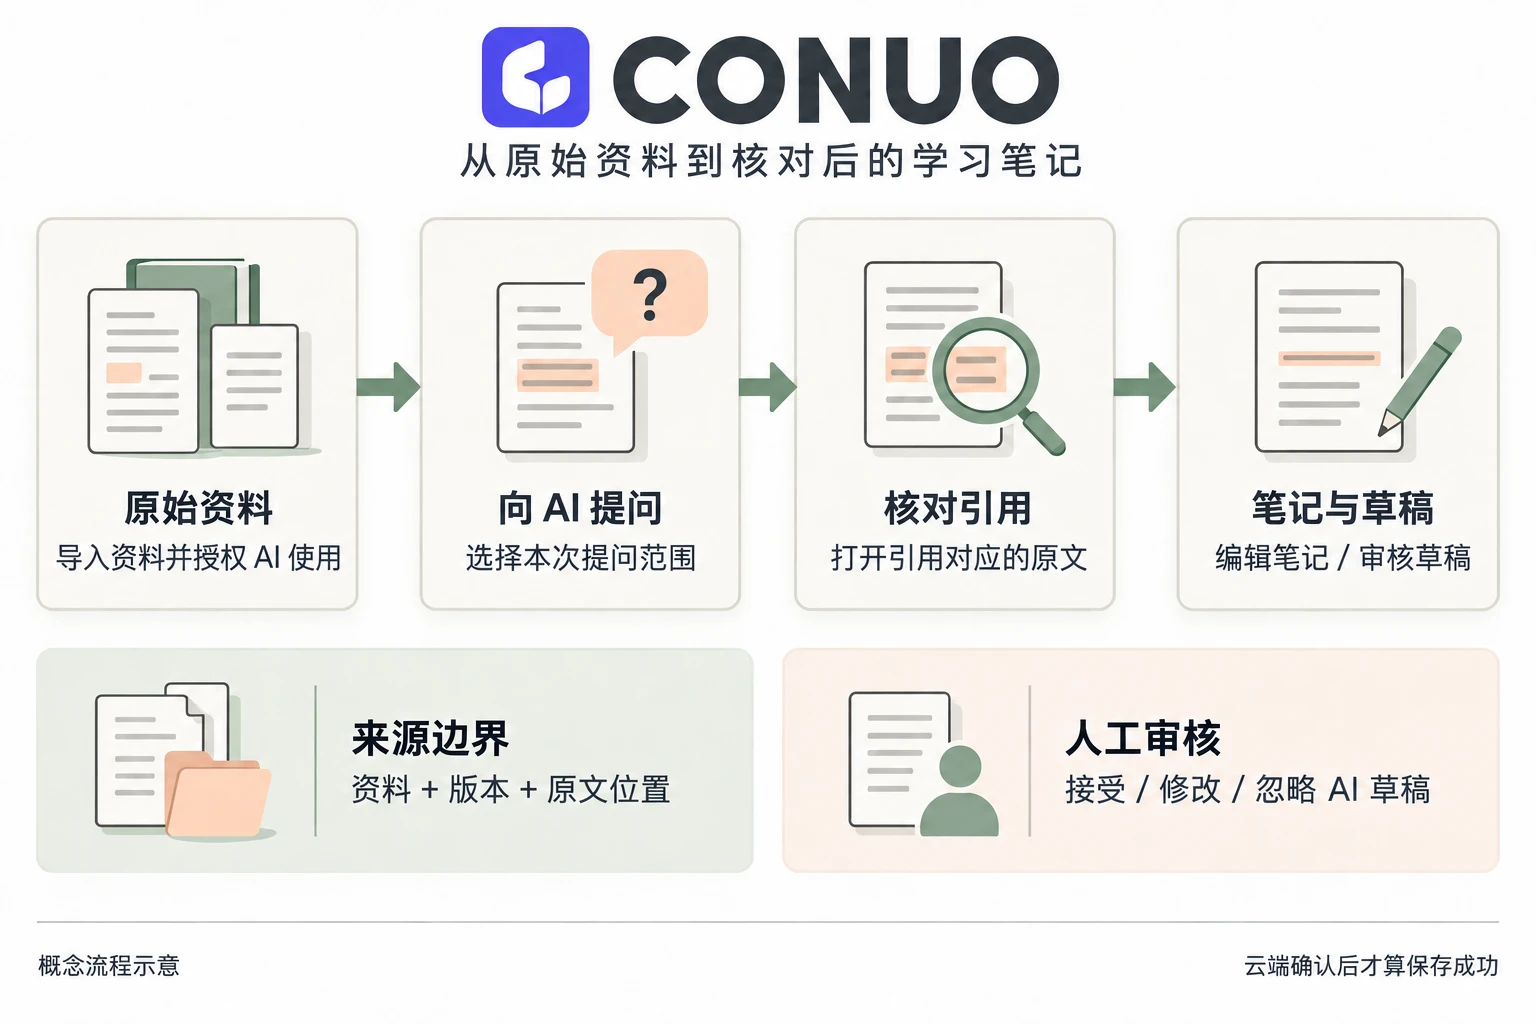
这样安排可以少做几次窗口切换、背景复制和引用整理。它能否让学习更有效,还需要结合实际使用观察,目前没有测量过学习效率或准确率收益。
用一份资料走完阅读流程
1. 导入资料,确认 AI 可以使用哪些内容
当前支持 PDF、DOCX、Markdown、TXT 和网页资料。导入时先检查解析预览,确认正文是否可用。网页可以提取公开文章,也可以由用户粘贴正文;只保存链接并不意味着已经获得整篇文章的内容。
新资料默认关闭 AI 使用权限。需要提问或整理时,再明确授权。没有授权的资料仍可以阅读和进行普通搜索,不会因为放进资料库就自动发送给模型。
2. 选择范围,问一个可以回到原文核对的问题
提问可以围绕选中的原文、当前资料或明确选择的资料集合。范围应该对应问题需要的依据,避免把不相关资料一起带进来。
联调资料中有一个固定例子:y = x² 在 x = 2 处的导数是 4,但 h = 0.1 时的割线斜率是 4.1。可以这样问:
只依据选定的资料,解释 h = 0.1 时的割线斜率为什么不等于导数。
列出原文中的计算步骤,并给出对应引用。
如果需要补充资料没有写出的推导,请单独说明。
这个例子既能核对计算,也能检查回答有没有混淆割线与切线。它是人工编写的测试材料,不代表模型处理任意数学资料都能得到正确结果。
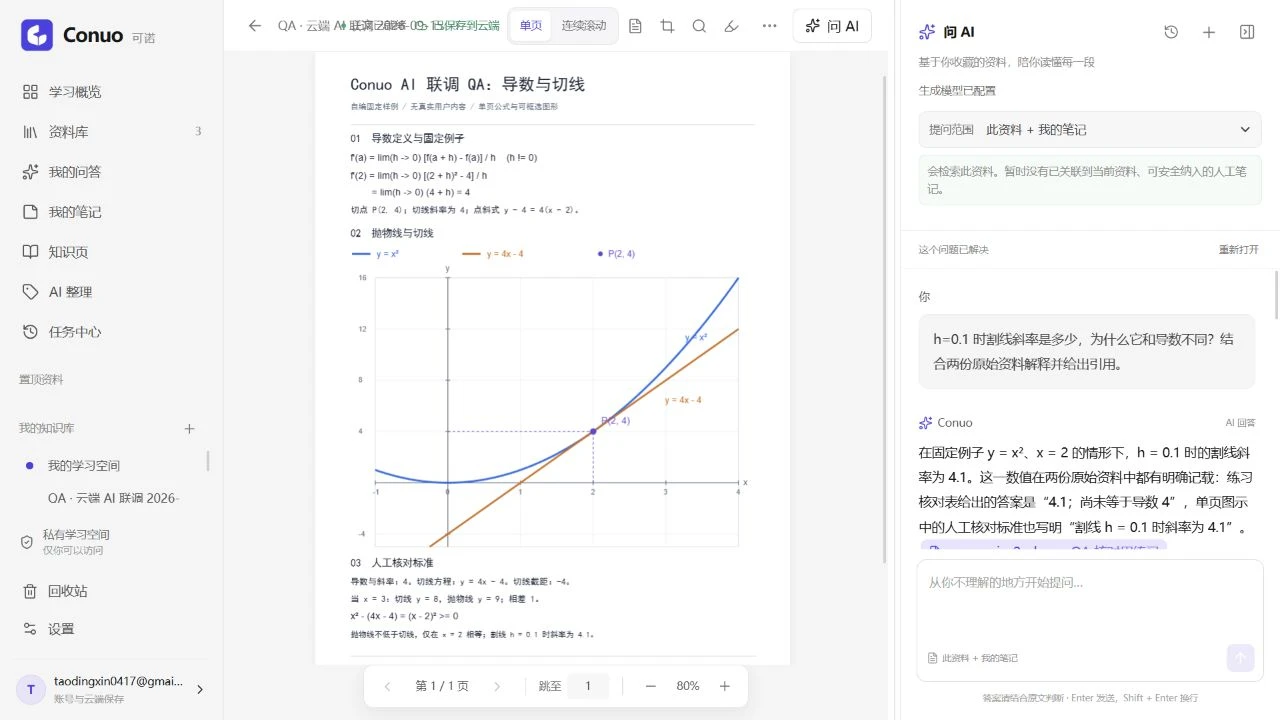
3. 打开引用,检查解释是否有依据
引用需要对应资料、版本和原文位置。核对时不只看“有没有引用”,还要检查它是否支持当前这句话,公式中的条件有没有被省略,以及模型是否添加了原文没有给出的结论。
资料替换成新版本后,旧引用继续保留原来的版本身份。历史依据不可用时,界面应该说明原因,不能用新版中的相似段落替代旧引用。
系统能检查来源身份和可访问性,但这不等于判断回答一定正确。特别是推导、比较和概括,仍需要用户对照内容检查。
4. 看不懂图表时,明确发送一个局部区域
PDF 中的图、公式或扫描页局部内容,可以通过区域框选交给视觉模型。先框选当前页的矩形区域,查看截图预览,再选择解读、针对区域提问或生成一次性练习。拖动和预览不会自动调用模型,只有明确发送后才会传输截图。
例如,可以框住抛物线与切线的交点,问“图中哪些信息说明这条直线在该点相切”,再对照页面上的公式核验解释。
这条流程不等于整页 OCR,也不会把扫描 PDF 的全部正文变成可检索文本。截图默认只用于当前请求,结果是一次性面板内容,目前没有刷新后恢复为长期学习档案的入口。
5. 保存有用的内容,补上自己的理解
只有完成并通过引用校验的回答,才进入可另存的流程。用户可以保存为笔记,也可以将带原文引用的内容追加到当前知识库的知识页,随后继续编辑与审核。
如果使用“此资料 + 我的笔记”范围,个人笔记会作为单独的依据展示,不会冒充原文。当前这类回答还不能直接另存为笔记或知识页,避免只保存正文却丢失个人笔记的来源结构。
流式生成时看到的段落只是预览;停止后保留的未完成记录不能当作完整笔记保存。编辑完成后,还要看到“已保存到云端”的确认,才能确定这次修改已经留下来。
知识页为什么保留审核步骤
一段问答通常围绕一个局部问题。知识页则需要把概念、解释、例子和来源组织起来,方便以后继续读。
Conuo 可以根据明确选择的资料提出主题草稿。用户逐份检查,接受需要的内容、改写不准确的部分,或忽略不合适的建议。更新已有知识页时,也先展示建议的变更,而不是直接替换正文。
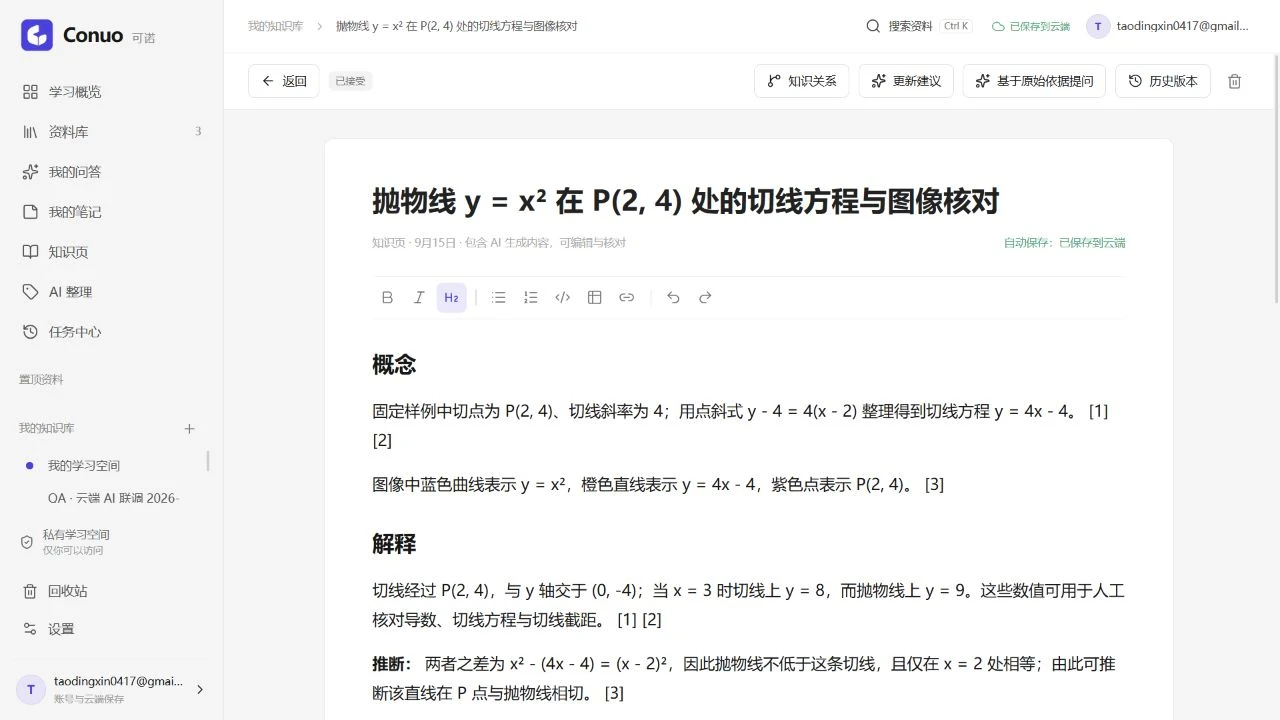
接受草稿表示用户选择把它纳入自己的知识页,不是系统证明其中每句话都正确。页面继续保留 AI 生成标记和来源,便于后续复查。
知识页的“基于原始依据提问”使用关联的原始资料,而不是把知识页正文再当成原文喂给模型。这样,之前生成的解释不会因为被保存过,就自动成为下一次回答的事实依据。
开发中主要解决了哪些问题
界面使用 Next.js、React 和 TypeScript。PDF.js 提供原页阅读、文字选择与缩放,Tiptap 用于编辑笔记和知识页。阅读器与对话并排后,还需要处理页码、选段、引用位置和资料版本之间的对应关系。
服务端根据当前用户、资料权限和版本准备模型输入,并校验返回的引用。模型配置与密钥留在服务端。对话中的近期用户问题可以帮助理解追问,但助手之前的回答不会自动被当作资料事实。
当前 Web 必须登录,以 Supabase 数据库和私有文件存储作为正式存储。浏览器只暂存当前编辑;断网、云端拒绝保存或响应不确定时,需要显示真实状态。刷新页面会重新读取云端,尚未保存的编辑和未应用的审核修改可能丢失。后续桌面版的本地与云端共存方案尚未实现,不能把当前 Web 描述成离线知识库。
这部分开发让我更重视“内容是什么状态”:原文、生成预览、待审核草稿、用户接受的知识页和云端已确认内容,都需要有清楚的区分。单独接通模型接口,还没有完成这些产品细节。
当前验证到哪里
已有真实模型与登录账号的有限联调,覆盖资料问答、引用核对、回答保存为笔记、PDF 区域解读与问答、一次性练习,以及知识草稿接受后的云端保存和刷新恢复。
仍需要补齐的部分包括:
- 真实跨账号与双设备并发、断网和保存冲突的完整验收。
- 生产环境的持久后台处理。当前开发页面运行不代表关闭页面后任务仍会继续。
- 向量检索的完整真实链路。当前不能将局部问答或已有关键词检索描述为整库语义问答已经完成。
现阶段可以展示已实现的阅读流程和工程处理方式,但还不是可公开注册使用的正式产品。
继续阅读
完整界面与技术概览见 Conuo 项目页。如果关注怎样把核对要求写进 AI 的任务说明,可以继续读结构化与流程化:把工作交给 AI 之前;关于上下文准备和结果检查,见AI 编程实践:上下文、验证与成本。
继续阅读